Une catégorisation métier guidée par les prestations et les domaines de formation.
API OpenAIGPT-5 miniPrompt engineeringClassification
Explorer le projet ↗
Contexte
Enrichir les données des Junior-Entreprises pour mieux caractériser leur positionnement à partir de leur offre de prestations et des domaines de leur école.
Mon rôle
J’ai conçu l’enrichissement par IA et les instructions de catégorisation.
Contributions
Utilisation de l’API OpenAI avec GPT-5 mini pour produire des catégories à partir des informations disponibles.
Rédaction d’instructions spécifiques et d’exemples pour guider la catégorisation.
Définition de catégories telles que ingénieur numérique, mécanique / industriel, commerce / management, université pluridisciplinaire, design / communication, santé / pharmacie ou agro / environnement.
Résultats & limites
Enrichissement des données par catégories métier. Le taux de justesse, le volume traité et le coût total restent à mesurer.
Mesures à compléter
Jeu annoté et accord avec les catégories attendues
Gestion des catégories ambiguës ou redondantes
Volume enrichi, coût par fiche et révision humaine
Lecture fonctionnelle
Vue fonctionnelle de la catégorisation. Format de sortie, règles de validation et mode de stockage à préciser.
Recherche web en plusieurs passes et modèle local pour retrouver les parcours professionnels.
Mini Mistral · localMac miniSerper.devRecherche multi-passe
Explorer le projet ↗
Contexte
Projet d’annuaire interne portant sur un référentiel de 90 000 profils de Junior-Entrepreneurs de la CNJE. Ce volume décrit le périmètre de données, pas le nombre de correspondances validées.
Mon rôle
J’ai développé le processus de recherche et d’enrichissement des profils.
Contributions
Hébergement d’un modèle Mini Mistral sur un Mac mini pour le traitement IA local.
Recherches Internet via Serper.dev, avec reformulation lorsque les premiers résultats ne conviennent pas et arrêt après cinq scénarios au maximum.
Extraction du métier, du poste, de l’entreprise, de la localisation et de l’URL LinkedIn candidate.
Association d’un indice de confiance de l’IA à chaque résultat pour aider à la revue et à l’amélioration.
Résultats & limites
78 % des profils trouvés et enrichis sur le périmètre de l’annuaire de 90 000 profils. Ce taux mesure la couverture de l’enrichissement, pas l’exactitude des correspondances. La part validée manuellement et le taux de faux rapprochements ne sont pas fournis. L’indice de confiance de l’IA n’est pas une probabilité d’identité correcte validée.
Mesures à compléter
Part des profils enrichis validée manuellement et taux de faux rapprochements
Nombre moyen de scénarios et coût des recherches
Calibration de la confiance sur un échantillon revu manuellement
Lecture fonctionnelle
Recherche web externe via Serper.dev et inférence locale sur Mac mini. La recherche est réorientée lorsque nécessaire, avec arrêt après cinq scénarios au maximum. L’identifiant exact du modèle reste à préciser.
Projet industriel de validation de données et de documents, avec une approche combinant règles explicites, IA générative et validation humaine. Le client et ses données restent anonymes.
Mon rôle
Développement full-stack, formalisation des règles avec les experts métier, proposition du chatbot documentaire et démonstrations client. Poursuite autonome du développement sur une partie du stage.
Contributions
Développement d’une interface React / TypeScript et d’API Python FastAPI ; normalisation des échanges JSON et export des résultats vers Excel.
Automatisation de contrôles de format et de cohérence, complétée par des prédicteurs DSPy avec entrées et sorties contraintes.
Intégration de LLM via Azure OpenAI, post-traitement déterministe et validation des suggestions par l’utilisateur.
Pipeline documentaire : ingestion PDF, OCR local si nécessaire, structuration par sections, extraction par LLM, normalisation puis export.
Chatbot contraint au contenu du document, avec références aux sections utilisées et indice de confiance calculé à partir des log-probabilités des tokens.
Résultats & limites
Évaluation de l’extraction sur 1 064 documents annotés manuellement. Précisions par champ : nom du produit 90,3 %, date 98,3 %, langue 98,2 %, version 98,6 %, identifiants 94,5 % et mentions de danger 93,3 %. Les règles de comparaison incluent une tolérance de date de ± un mois et un seuil de similarité de 80 % pour les noms. Traitement documentaire huit fois plus rapide que le manuel ; le protocole chronométrique complet n’est pas fourni. Les prédicteurs obtiennent des F1 de 0,69, 0,74 et environ 0,81, à interpréter avec prudence : quatre fichiers sources et pas de séparation entraînement/test clairement décrite. Le code et les livrables ont été remis au client ; la mise en production finale n’est pas attestée.
Mesures à compléter
Détail des effectifs par champ, erreurs et protocole de comparaison
Validation indépendante sur des documents non vus
Mesure de latence et de coût par étape ; calibration de la confiance
Lecture fonctionnelle
Vue synthétique de l’architecture. Les versions exactes des modèles restent à préciser.
Regrouper des données techniques par similarité en conservant une interprétation des groupes au moyen d’exemples réels : les médoïdes. La mission freelance prolonge les travaux du stage, avec un développement principalement consacré au clustering quantique.
Mon rôle
J’ai contribué au prétraitement, aux expérimentations et à la mise en œuvre de l’approche hybride avec les chercheurs. Durant la mission freelance, je me suis surtout consacré au développement du clustering quantique, principal projet de la startup à cette période. Les travaux théoriques et les baselines ont été élaborés en équipe.
Contributions
Exploration de données mixtes, traitement des valeurs manquantes, réduction des redondances et réduction dimensionnelle.
Calcul des dissimilarités et reformulation du clustering K-Medoids en optimisation binaire quadratique sans contrainte (QUBO).
Résolution hybride via D-Wave Leap, puis décodage des médoïdes et affectation des points.
Étude comparative avec des méthodes classiques : PAM, recuit simulé et recherche Tabu dans le cadre des expérimentations.
Pipelines d’expérimentation Python ; NumPy, Pandas, PyTorch et Scikit-learn utilisés pendant la mission freelance.
Résultats & limites
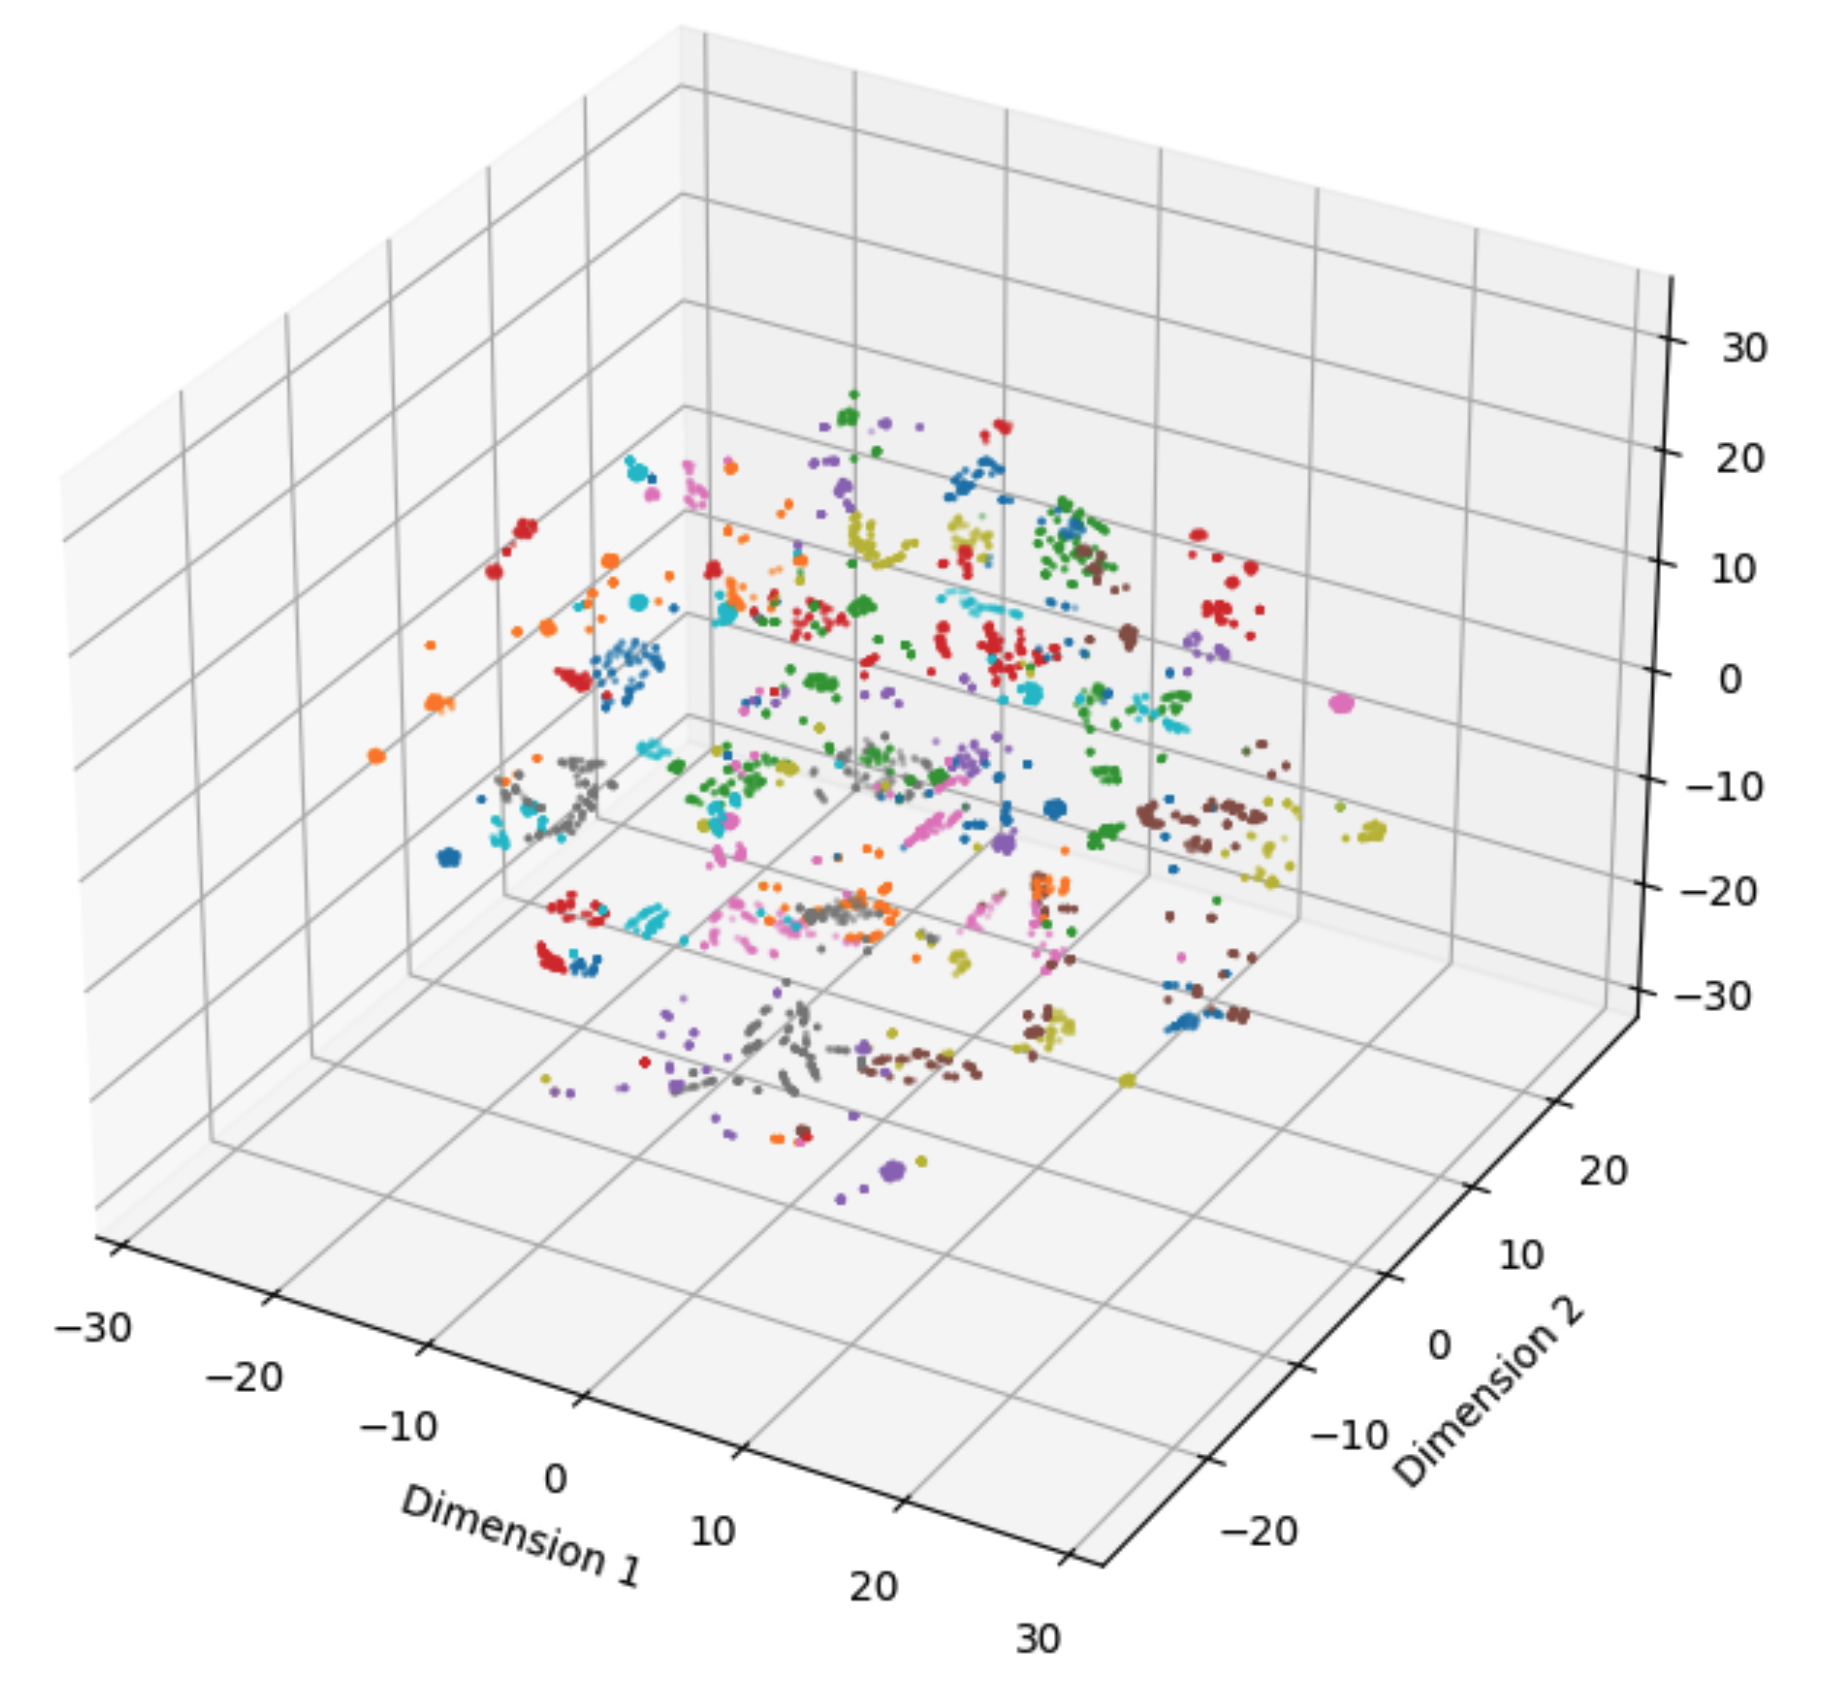
Chaîne d’expérimentation et visualisations de clusters. Aucun gain quantique chiffré reproductible n’est revendiqué ici. Les conclusions comparatives nécessitent les conditions de calcul, les paramètres et les résultats bruts.
Mesures à compléter
Hyperparamètres, seeds, versions et coût du solveur
Qualité du clustering et temps total face aux baselines
Lecture fonctionnelle
Vue synthétique des étapes de traitement. Formulations propriétaires, données du client et configurations internes non reproduites.
Prétraitement & réduction de dimension
Matrice de dissimilarités
QUBO & solveur hybride
Médoïdes & affectation aux clusters
Représentation 3D des clusters de véhicules formés
06QbitSoft · Recherche2023–2024 · travaux de recherche
Q-Seg · segmenter les images satellitaires
Une segmentation non supervisée par graphes et optimisation quantique.
Q-SegQUBOD-WaveSegmentation non superviséeIoU
Explorer le projet ↗
Contexte
Identifier des zones d’eau dans des images satellitaires par une méthode non supervisée, tout en adaptant le calcul aux contraintes matérielles.
Mon rôle
Contribution à la segmentation d’images et à son intégration dans une chaîne d’analyse, en collaboration avec les chercheurs QbitSoft.
Contributions
Préparation d’une représentation spectrale mettant en évidence l’eau, puis découpage en sous-images.
Transformation des pixels en graphe pondéré et formulation du problème de segmentation en QUBO.
Appel à un solveur D-Wave, décodage binaire puis réassemblage des masques.
Évaluation par intersection sur union (IoU) ; aucune valeur numérique exploitable n’est fournie.
Résultats & limites
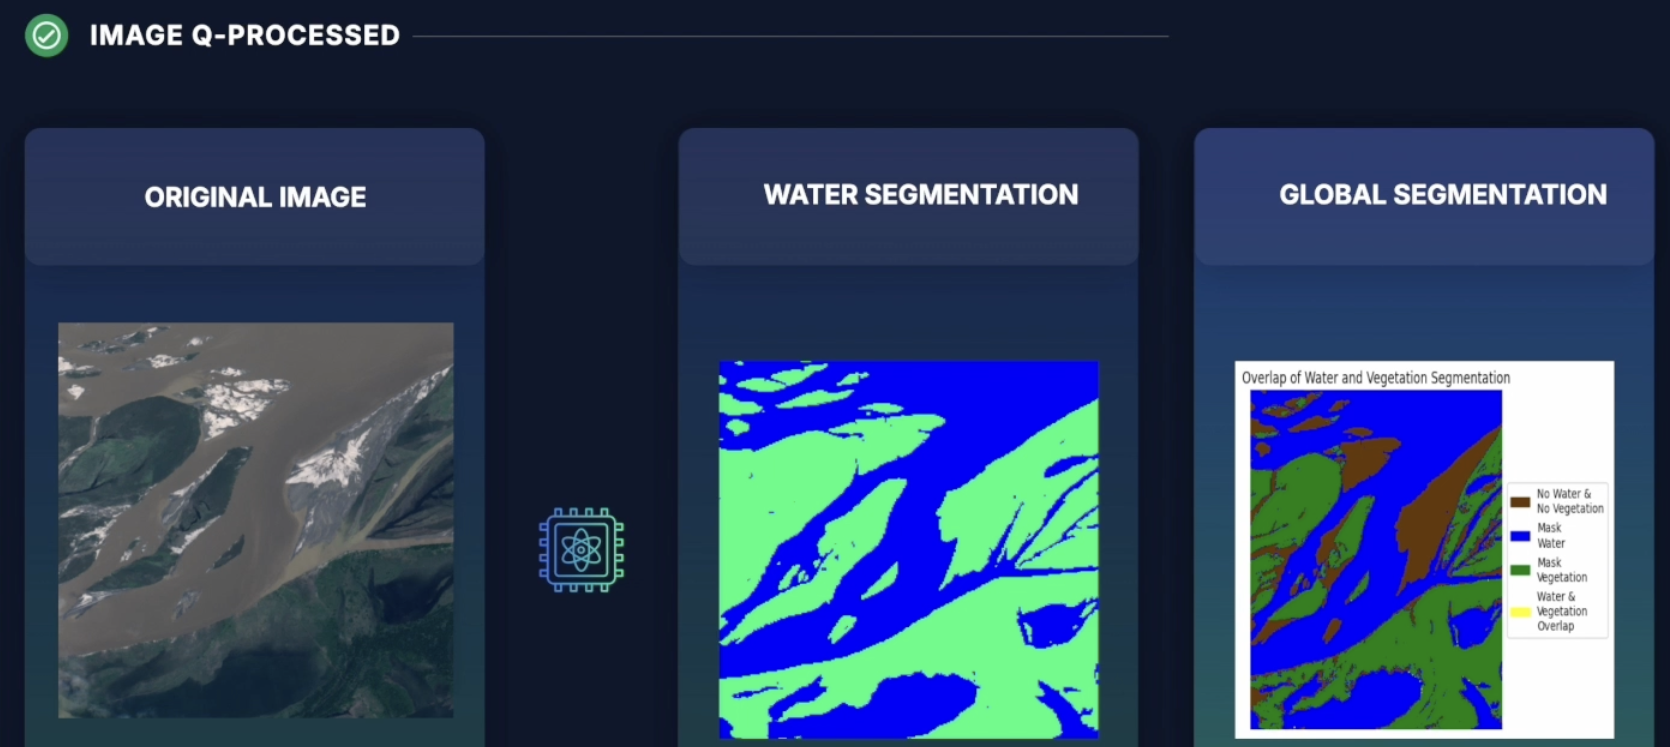
Production de masques d’eau et de segmentation, illustrée ci-dessous. L’IoU est utilisée pour l’évaluation, mais aucun score n’est présenté ici pour chiffrer une performance ou un avantage sur une méthode de référence.
Mesures à compléter
Capteur, données et annotations de référence
IoU agrégée, dispersion et taille du jeu de test
Temps de traitement complet et effet du découpage
Lecture fonctionnelle
Vue synthétique du pipeline de segmentation. Le capteur, le jeu d’images, les bibliothèques et la désignation exacte de l’indice spectral restent à préciser.
Image satellitaire & indice spectral
Découpage & graphe pondéré
Optimisation D-Wave
Réassemblage du masque & IoU
Image d’origine, segmentation de l’eau et segmentation globale. Illustration de sortie, sans score de performance associé.
Pipeline BOAMP, recommandations et assistant documentaire sur AWS.
PythonBOAMPAWSDynamoDBNuxt / Vue.jsGroqGPT-4oRAG
Explorer le projet ↗
Contexte
Projet académique en équipe de cinq pour centraliser, filtrer et analyser les appels d’offres publics du BOAMP, avec interfaces utilisateur et administrateur.
Mon rôle
Lead Data au sein du projet. L’interface, le cloud et le pilotage relèvent d’une réalisation collective.
Contributions
Chaîne data Python : récupération BOAMP, filtrage par date et marché, traitement des valeurs manquantes et sélection des colonnes.
Enrichissement par LLM via Groq ; le modèle exact utilisé derrière ce service n’est pas précisé.
Stockage DynamoDB séparant les appels d’offres en cours et les marchés attribués.
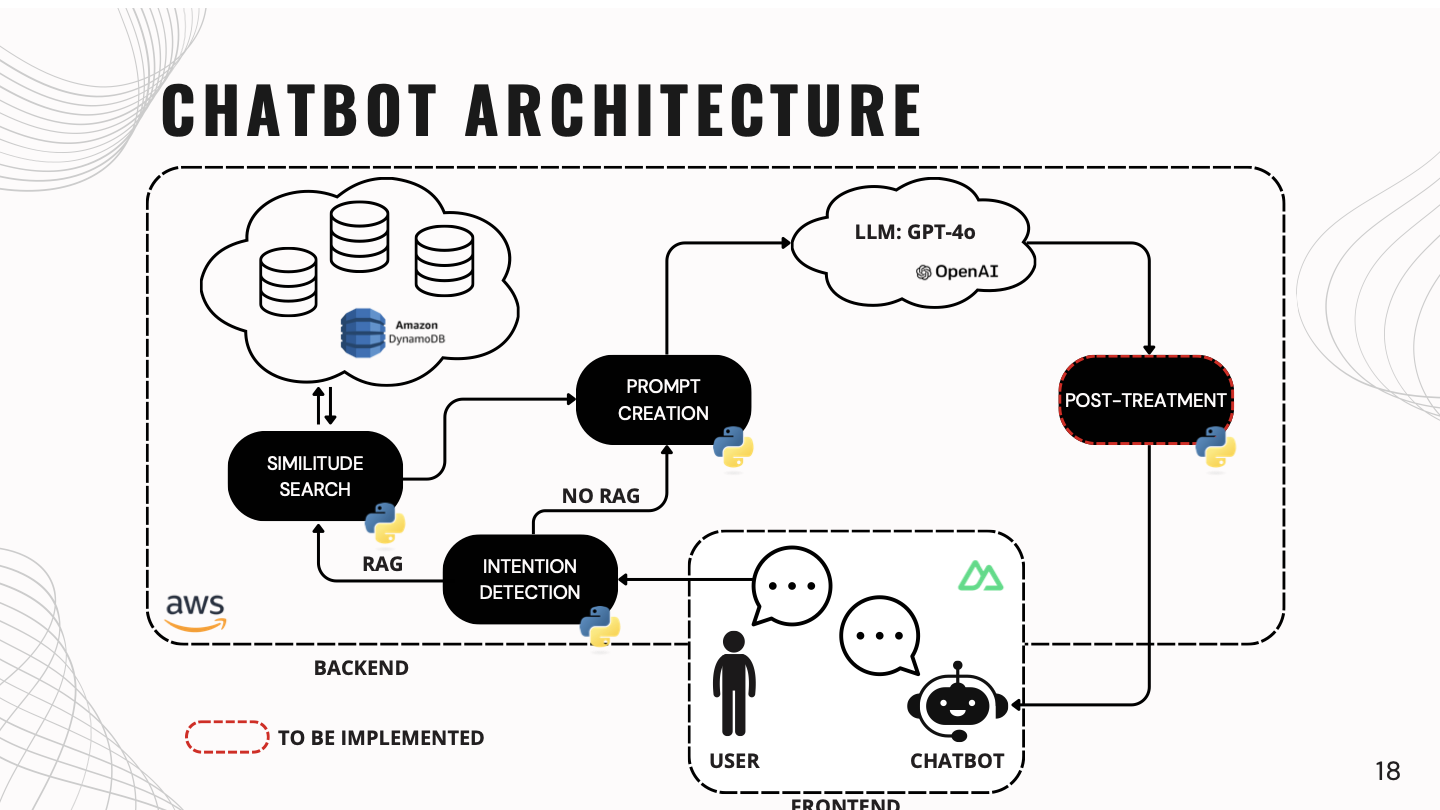
Architecture du chatbot : détection d’intention, recherche de similarité selon le besoin, création du prompt et appel à GPT-4o.
Application Nuxt sur AWS, avec personnalisation de l’interface, administration des accès et recommandations, développée en équipe.
Résultats & limites
Plateforme avec interface utilisateur, administration, chatbot et recommandations. La pertinence, la charge supportée et le gain commercial restent à mesurer. Les évolutions Salesforce et l’élargissement historique sont des perspectives.
Mesures à compléter
Volume effectivement ingéré et fréquence des mises à jour
Évaluation des recommandations et de la fidélité des réponses
État final des deux modules marqués « à implémenter »
Lecture fonctionnelle
Vue synthétique de l’architecture. Les modules « Interpret data » et de post-traitement du chatbot restent identifiés comme à implémenter ; ils ne sont pas présentés comme livrés.
Transformer des avis de restaurants en indicateurs et recommandations dans le cadre d’un projet collectif.
Mon rôle
Nous avons travaillé à trois sur l’ensemble des tâches data, le code Python, les interfaces Tkinter et Flask et le déploiement Azure.
Contributions
Import CSV ou récupération paginée des avis via le service tiers The Fork / The Spoon sur RapidAPI ; filtrage de la langue anglaise avec langdetect.
Manipulation des avis avec Pandas et analyse de sentiment avec Transformers pipeline("sentiment-analysis") : étiquette et score par avis.
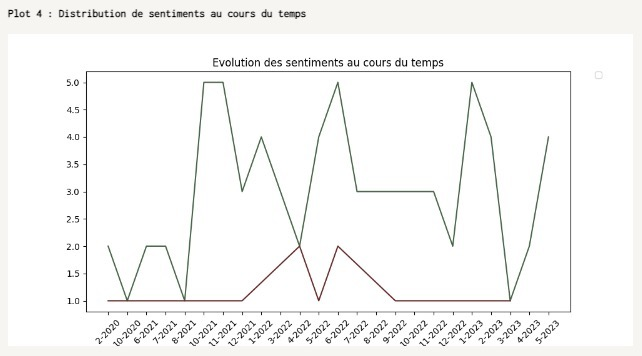
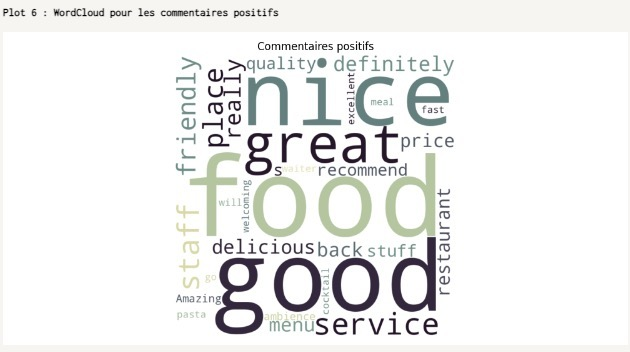
Graphiques Matplotlib / Seaborn : distributions, notes et évolution temporelle ; nuages de mots avec WordCloud.
Génération de conseils via GPT-3.5 Turbo à partir de statistiques et d’un prompt.
Développement d’un prototype Tkinter puis d’une version web Flask avec templates HTML, déployée sur Azure.
Résultats & limites
Collecte d’avis, analyse de sentiment, graphiques et génération de conseils. Aucun score de classification sur un jeu de test annoté n’est présenté. Le score renvoyé par le modèle n’est pas une mesure d’exactitude. Les graphiques illustrent un cas d’usage, sans constituer un benchmark.
Mesures à compléter
Modèle de sentiment et versions des dépendances
Volume d’avis, métriques sur jeu annoté et validation des agrégats
Lecture fonctionnelle
Du prototype Tkinter à l’application web Flask déployée sur Azure. La référence exacte du modèle de sentiment reste à préciser.
CSV / RapidAPI
Pandas & filtre de langue
Sentiments Transformers
Visualisations & conseils GPT
Exemple de visualisation de l’évolution des sentiments.Nuage de mots agrégé des avis positifs.
Prototype académique collectif de vision et de simulation de drones, associant perception vidéo, environnement 3D et actionnement matériel.
Mon rôle
Je me suis occupé de Python / OpenCV, de la coordination du projet et de l’électronique, avec mon propre drone Parrot Anafi. Le projet a été réalisé en équipe de quatre ; la partie Unreal / C++ relève du travail de l’équipe.
Contributions
Acquisition du flux du Parrot Anafi en Wi-Fi ; le programme Python utilise OpenCV et FFmpeg pour lire un flux RTSP.
Conversion en niveaux de gris et détection de visages par cascade de Haar. La reconnaissance nominative est une fonction distincte, dont l’implémentation complète reste à détailler.
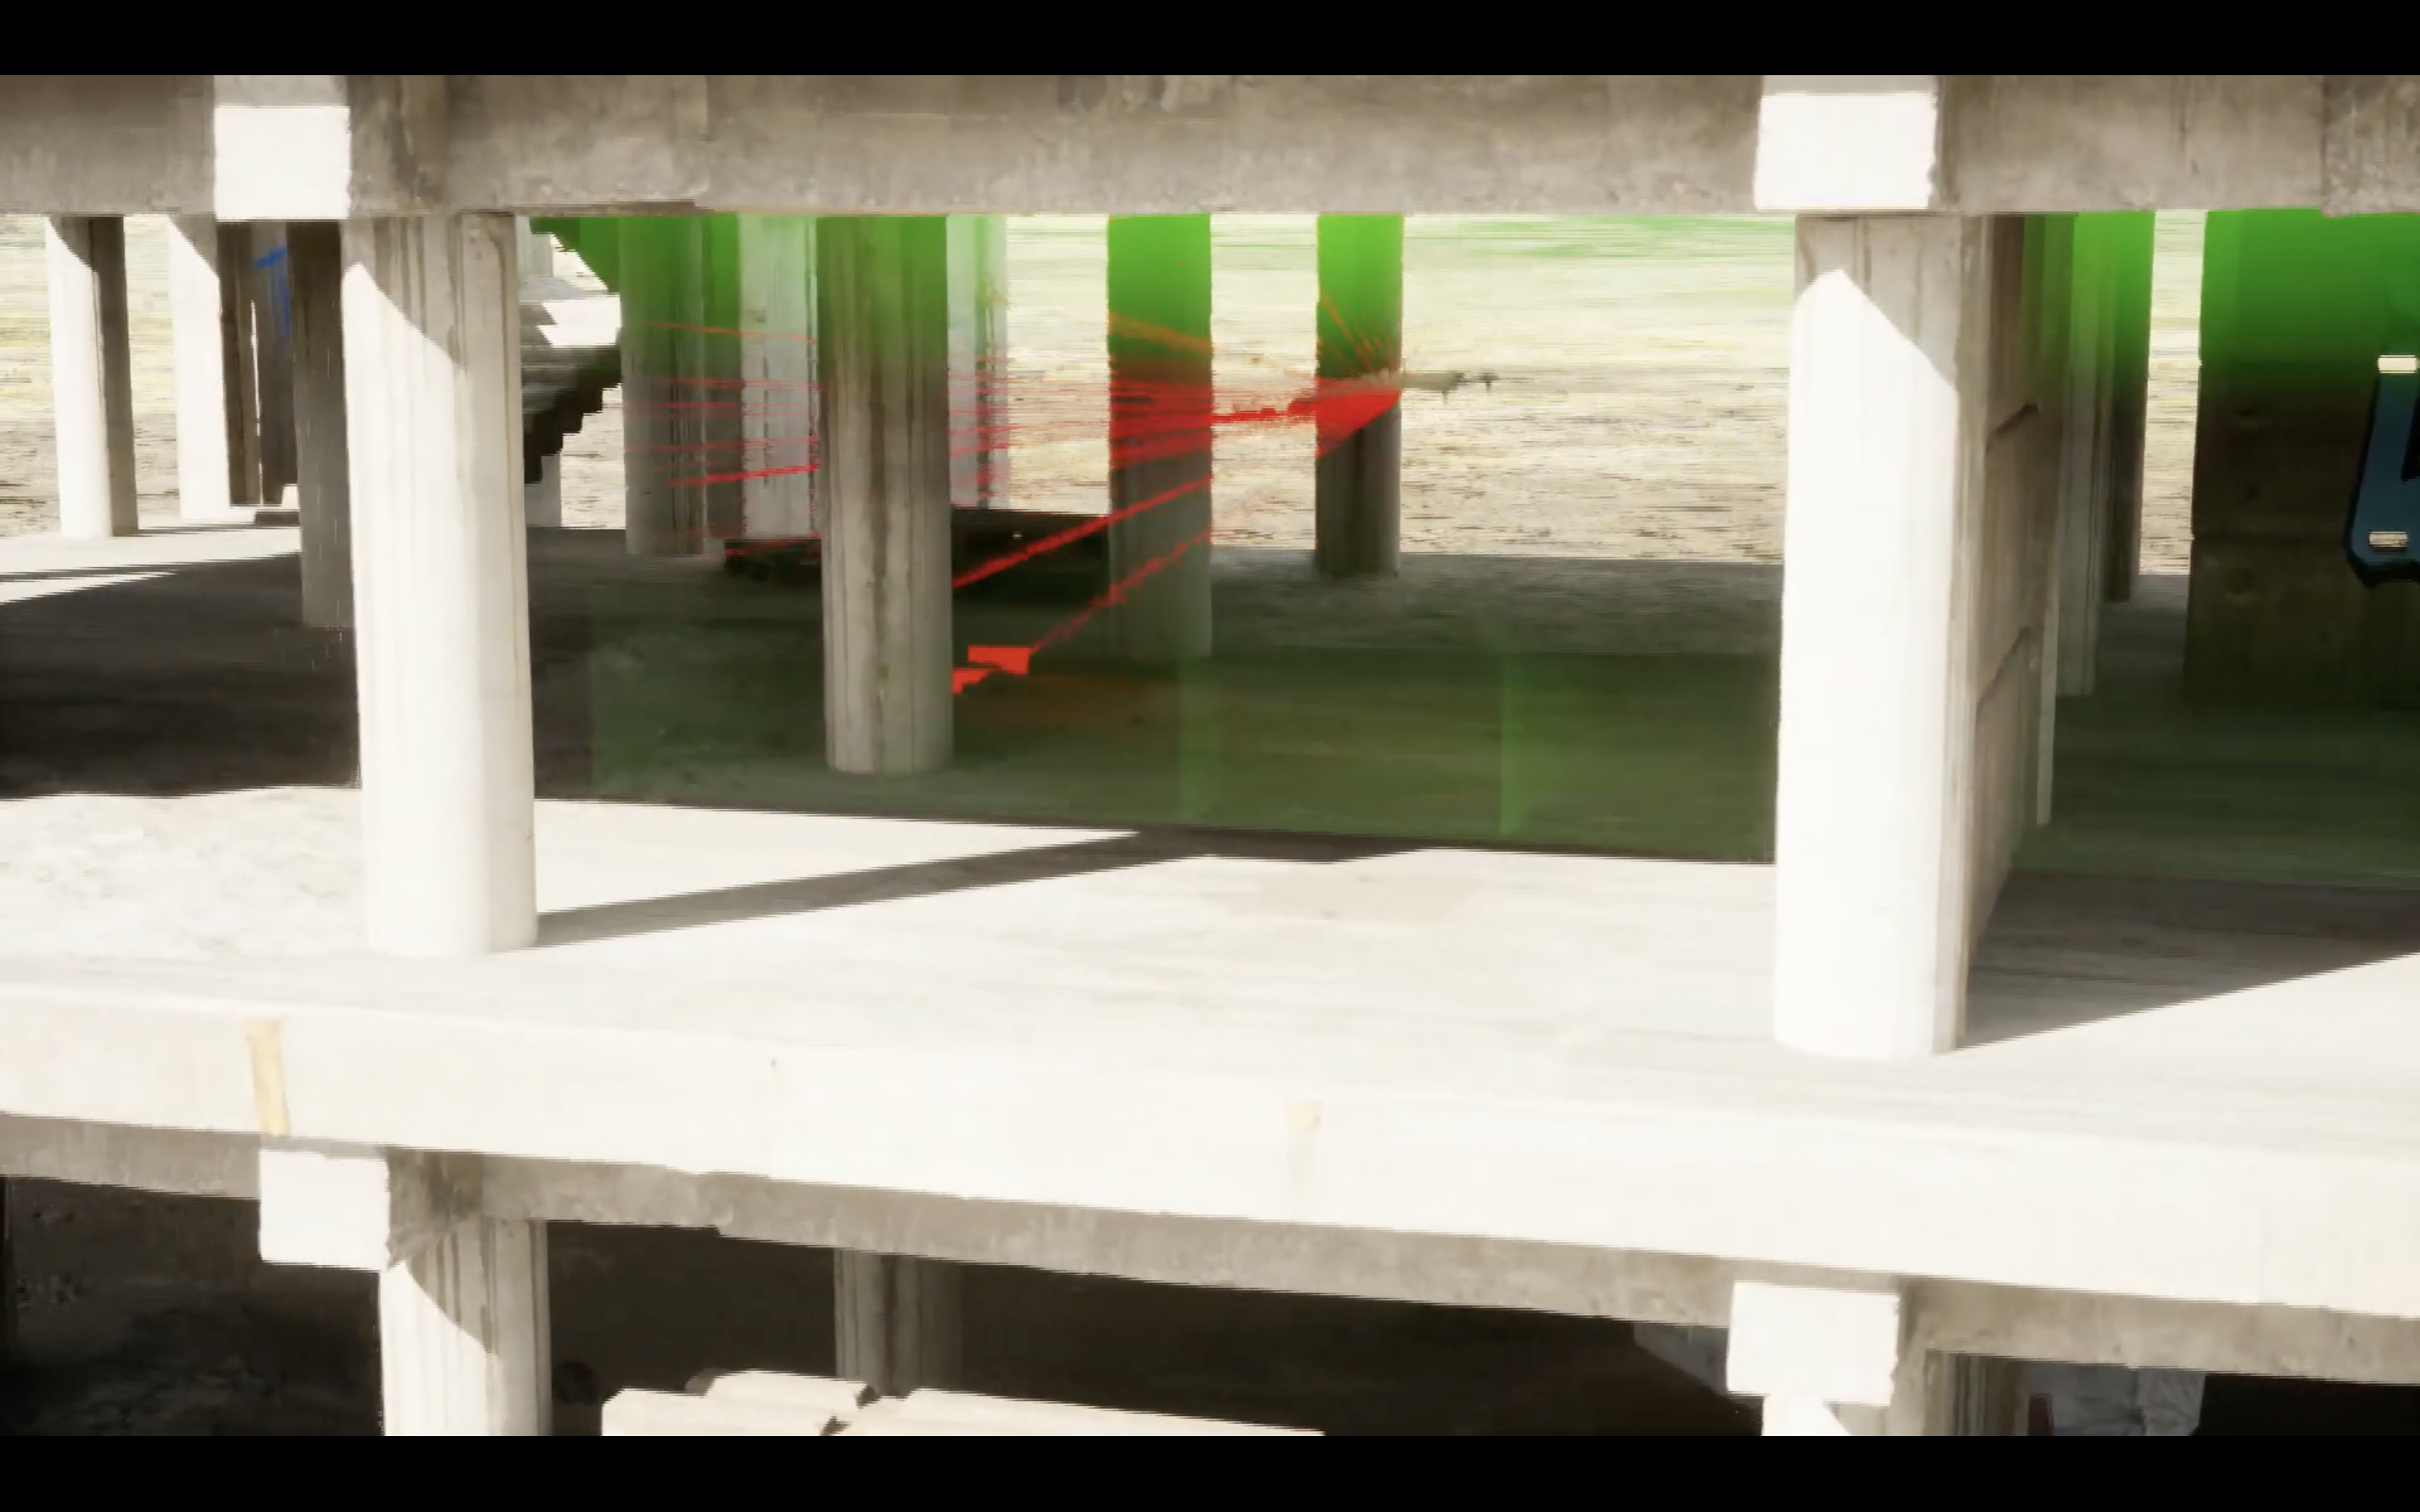
Simulation dans Unreal Engine, avec MetaHuman et Quixel Megascans pour l’environnement ; caméra et lidar simulés.
Envoi d’images depuis Unreal vers Python par socket TCP, avec un programme C++ .
Déclenchement d’un gyrophare par Arduino et relais 12 V dans le prototype matériel.
Résultats & limites
Simulation et essais avec un Parrot Anafi et un gyrophare. Résultats annoncés : > 91 % de réussite pour la coordination / communication et classement 6e sur 220. Le protocole du taux de réussite et le justificatif du classement restent à compléter. Aucun score de reconnaissance faciale n’est établi.
Mesures à compléter
Protocole du taux > 91 % et justificatif du classement
Bibliothèque et validation de la reconnaissance nominative
Latence vidéo, FPS et robustesse en conditions variables
Lecture fonctionnelle
Vue synthétique du prototype. Les communications du flux réel et de la simulation sont distinctes. La logique de reconnaissance nominative complète reste à détailler.
Des systèmes électroniques à la formation en fabrication numérique.
ArduinoRaspberry PiIoTImpression 3DCNC
Explorer le projet ↗
Contexte
Président et vice-président d’une association d’électronique et d’innovation.
Mon rôle
Président et vice-président, dans le cadre de mandats annuels de septembre à septembre. Participation à la formation des étudiants de l’EFREI aux machines de l’Innovation Lab.
Contributions
Conception, prototypage et programmation de systèmes électroniques.
Utilisation d’Arduino, Raspberry Pi, IoT et domotique.
Formation des étudiants de l’EFREI aux machines de l’Innovation Lab : impression 3D, découpe laser, usinage CNC et prototypage rapide.
Résultats & limites
Conception de systèmes électroniques et formation à la fabrication numérique. Le nombre de prototypes et de participants reste à préciser.
Mesures à compléter
Prototypes réalisés et cas d’usage
Nombre de formations et de participants
Fiabilité et retour d’usage des systèmes
Lecture fonctionnelle
Vue fonctionnelle des responsabilités et activités.